Robert Jan
Verstoep
Simon
Been
Martijn
de Waard
Eliza
Hobo
Patrick
Loffeld
AI IN HET INFORMATIEDOMEIN LIVE JON HOOFWIJK
AI in het informatiedomein live
Jon Hoofwijk
Studeerde algemene en vergelijkende literatuurwetenschap aan de Universiteit van Amsterdam en Universität Essen (D) en multimedia bij IBM; sinds 1996 schrijft hij over IT en aanverwante onderwerpen
In deze oktobereditie van het blad lees je niet deel #27 van de serie AI in het informatiedomein. Ter viering van 30 jaar Informatieprofessional sloegen Simon Been, de auteur van de artikelenreeks, en IP voor deze keer de handen ineen en organiseerden ze samen een inspirerende sessie bij het Stadsarchief Rotterdam. Een verslag van de praktijkervaringen van zes sprekers over – jawel, toch – AI in het informatiedomein.
Dinsdag 29 september, na het middaguur. In het Stadsarchief Rotterdam komen vakgenoten bijeen om te luisteren naar een gevarieerd gezelschap van sprekers van overheden en non-profitorganisaties en uit het bedrijfsleven. En om met elkaar in gesprek te gaan natuurlijk. De middag is georganiseerd als een heterdaadsessie, de term die Simon Been (Papieren Tijger Netwerk) gebruikt voor zijn interactieve bijeenkomsten en kennissessies. Gastheer (en spreker) is Robert Jan Verstoep, teamleider e-depot, databeheer & innovatie bij het Stadsarchief Rotterdam; Eric Daamen, teamleider Bureau Stadsarchivaris, is medeorganisator binnen het stadsarchief.
Been is nu eens niet auteur, maar middagvoorzitter. Het thema van de sessie luidt: ‘AI herschrijft het informatie-DNA: de informatieprofessie aan zet’. Been opent de middag met de stelling: ‘AI is een informatievraagstuk en dat is jouw domein!’ Voor de één is AI een fascinerend onderwerp dat de mensheid naar een nieuw niveau tilt en kansenongelijkheid verkleint. Voor de ander is het een doos van Pandora vol plagen, angst en beven. Hoe je het ook bekijkt, in het informatievakgebied kan en zal de impact groot zijn. ChatGPT en alle zusjes en broertjes daarvan veranderen het werken met, en genereren van, informatie structureel, houdt Been zijn publiek voor. Dat zal ook blijken uit de presentaties van de sprekers.
‘Het Stadsarchief maakt gebruik van AI om namen en entiteiten automatisch te herkennen zodat collecties beter vindbaar en verbonden zijn’
WELKOM BIJ HET STADSARCHIEF
Robert Jan Verstoep
Teamleider e-depot, databeheer en innovatie
Stadsarchief Rotterdam
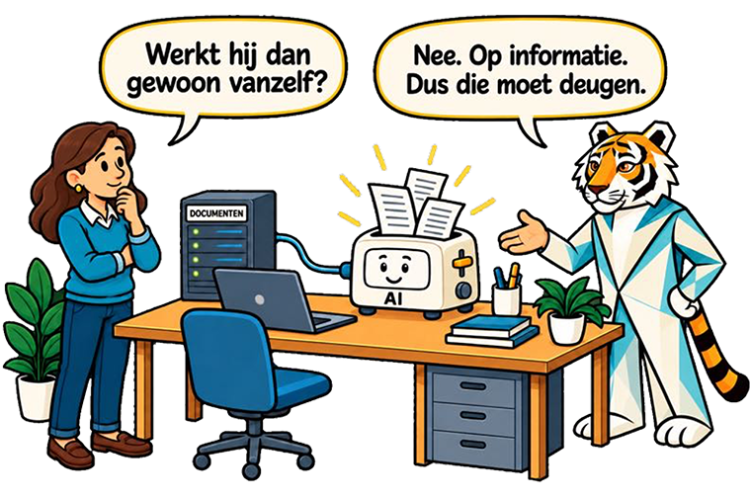
Werkt AI gewoon vanzelf?
Nee. Op informatie.
Dus die moet deugen.
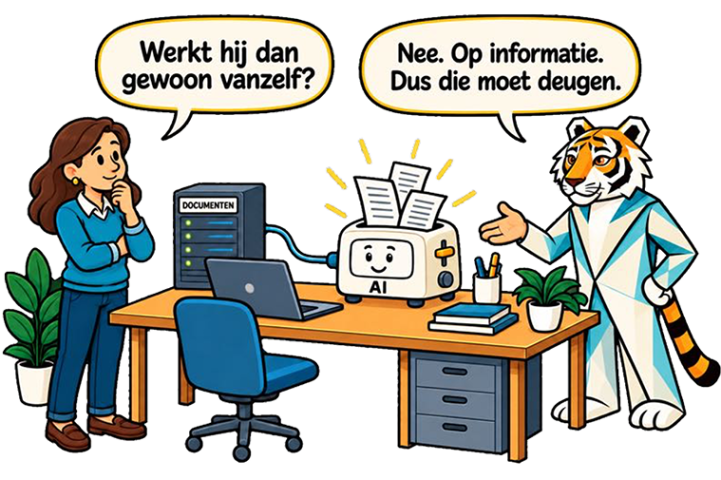
Robert Jan Verstoep laat zien hoe veelzijdig en actueel een modern archief kan zijn. Stadsarchief Rotterdam beheert de informatie en verhalen van de stad, houdt toezicht op het gemeentelijke informatiebeheer en werkt aan duurzame digitale toegankelijkheid. Met onderzoek, educatie en projecten rond actuele stedelijke vraagstukken verbindt het archief historische bronnen met het Rotterdam van vandaag. Ook werkt het samen met bewoners en maatschappelijke partners aan een collectie waarin uiteenlopende gemeenschappen en perspectieven zichtbaar worden.
VAN GARAGE TOT GEHEUGEN VAN DE STAD
Stadsarchief Rotterdam is gevestigd in de voormalige Rijks Automobiel Centrale van architect H.A. Maaskant. Het gebouw uit 1960 diende tot 1991 als garage voor ruim vierhonderd rijksvoertuigen waaronder die van de PTT. In 1995 besloot de gemeente om het leegstaande pand te verbouwen tot stadsarchief. Prins Claus opende het in 1999. Er is 6.000 vierkante meter depotruimte (ter vergelijking: De Kuip heeft een voetbalveld van 7.140 vierkante meter). Verder heeft het stadsarchief een koeldepot voor films. Bij de verbouwing werden milieuvriendelijke, duurzame materialen gebruikt, verhaalt Verstoep. Er is gelet op energiewinning en energiebesparing, zoals zonnepanelen op het dak, regenwater verzameld voor het doorspoelen van de toiletten, koude- en warmteopslag in de bodem voor de klimaatbeheersing in het gebouw en zoveel mogelijk daglicht en energiezuinige verlichting en apparatuur.
GEEN IT-, MAAR INFORMATIEVRAGEN
In het gebouw liggen eeuwen aan besluiten, akten, registers, kaarten en foto’s. ‘Al deze papieren documenten zijn in de loop van de tijd gedigitaliseerd’, vertelt Verstoep. ‘Verder is het archief uitgebreid met een e-depot: e-mails, databases, websites en documenten die nooit op papier hebben bestaan. Het stadsarchief zorgt ervoor dat deze digitale informatie tientallen jaren leesbaar en betrouwbaar blijft, volgens internationale standaarden.’
Het stadsarchief doet echter meer dan alleen bewaren. Beheerders kijken ook naar de herkomst van de informatie en naar de context waarin deze is ontstaan. En of het materiaal authentiek is – is het wat het zegt te zijn? Kortom, precies de vragen die nu op tafel liggen bij AI. ‘Het Stadsarchief maakt gebruik van AI om historische bronnen te doorzoeken’, zegt Verstoep. ‘En om handschrift om te zetten, en namen en entiteiten automatisch te herkennen zodat collecties beter vindbaar en verbonden zijn. Handmatig zou dit zeer bewerkelijk zijn. In akten en in de burgerlijke stand zitten immers miljoenen namen verborgen. Dit zijn geen IT-vragen, maar informatievragen waarbij alles draait om kwaliteit, metadata en verantwoordelijkheid.’
‘Een prompt geven is slechts één ervaring; AI voor kenniswerk is óók doorvragen, sparren, onderzoeken en herschrijven’
AI IS EEN INFORMATIEVRAAGSTUK
EN DAT IS JOUW DOMEIN
Simon Been
Auteur, spreker en trainer rond AI in het informatiedomein
TijgerBrains
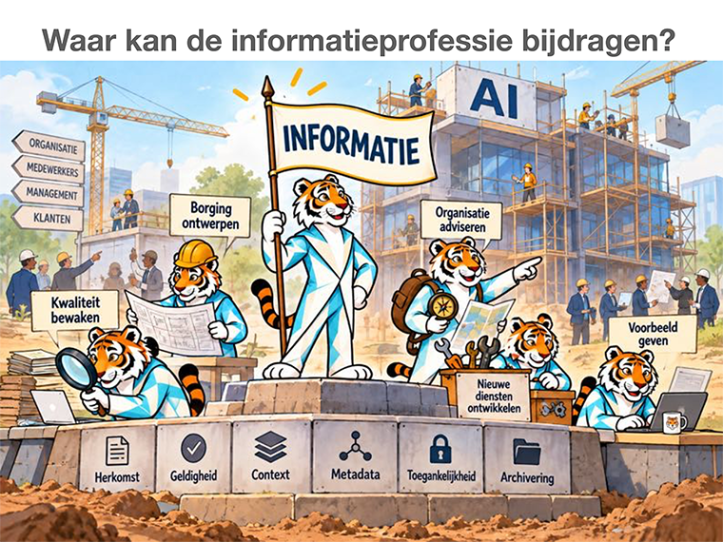
AI verandert de kern van kenniswerk. Midden in dit geheel staat de kenniswerker. Die geeft opdrachten, beoordeelt antwoorden en stuurt bij.
VIER MISVATTINGEN OVER AI
Simon Been begint zijn presentatie met de fundamentele vraag: wat is AI echt? Het antwoord geeft hij aan de hand van vier misvattingen over AI. De eerste misvatting is dat het gewoon een computer is waarbij alles om data draait. ‘Dat is niet juist. AI loopt op informatie. Alles draait om context en samenhang. AI is, kortom, een contextmachine. De tweede misvatting is dat veel mensen denken dat ze AI kennen als ze er een keer mee hebben geëxperimenteerd. Ook dat is niet zo. AI is zoveel meer dan een “brein”. Sinds de introductie van ChatGPT voor een breed publiek eind 2022 is er heel veel bijgekomen. De ontwikkelingen gaan razendsnel.’
De derde misvatting die Been noemt: als je een aantal keren prompts aan je computer hebt gegeven, weet je wat AI is. Nee dus. ‘Zo’n instructie, vraag of commando is slechts één ervaring. AI voor kenniswerk is óók doorvragen, sparren, onderzoeken en herschrijven. De laatste misvatting is dat de tekst of het antwoord van AI correct is als je dit maar nakijkt. Controle door de human in the loop is echter bij lange na niet genoeg. Je controleer alleen wat je kunt zien. Je weet niet hoe AI tot het antwoord is gekomen, welke bronnen er zijn gebruikt en welke niet.’
RELEVANTE INFORMATIE BUITEN BEELD
AI nestelt zich in de route van broninformatie naar adviezen, besluiten en dossiers, vertelt Been. ‘AI zoekt, selecteert, rangschikt, combineert, interpreteert en genereert. Relevante informatie kan buiten beeld blijven, terwijl concepten, oude versies of vaak herhaalde aannames juist gewicht krijgen. Voor de gebruiker blijft die selectie meestal grotendeels onzichtbaar. Uitkomsten van AI gebruikt AI later óók weer als bron. Een onduidelijke status, gemiste nuance of onjuiste aanname kan zo verder door de organisatie reizen en deel gaan uitmaken van het organisatiegeheugen.’
BEHOEFTE AAN INFORMATIE-INTELLIGENTIE
Elders in de organisatie verandert AI de kern van kenniswerk: van research tot analyse en van brainstormen tot sparren en formuleren. ‘Vertrouwde stappen worden overgeslagen. Status en herkomst van informatie worden diffuus, dossiers krijgen blinde vlekken. Gebrekkige AI-inzet opent daarmee diverse valkuilen, van ontoereikende informatiekwaliteit tot problematische verantwoording en een (nog meer) vervuild organisatiegeheugen’, aldus Been.
Zo herschrijft AI het informatie-DNA: de basisregels waarmee een organisatie bepaalt welke informatie zij vertrouwt, hoe zij die gebruikt, wat zij bewaart en hoe zij zich daarover verantwoord. ‘De human in the loop biedt geen soelaas wanneer zaken zoals bronkeuze, status, tussenstappen en doorwerking niet zichtbaar en toetsbaar zijn. Er is, kortom, een grote behoefte aan informatie-intelligentie voor betrouwbare inzet van AI.’
DUIDELIJK INFORMATIEMANDAAT NODIG
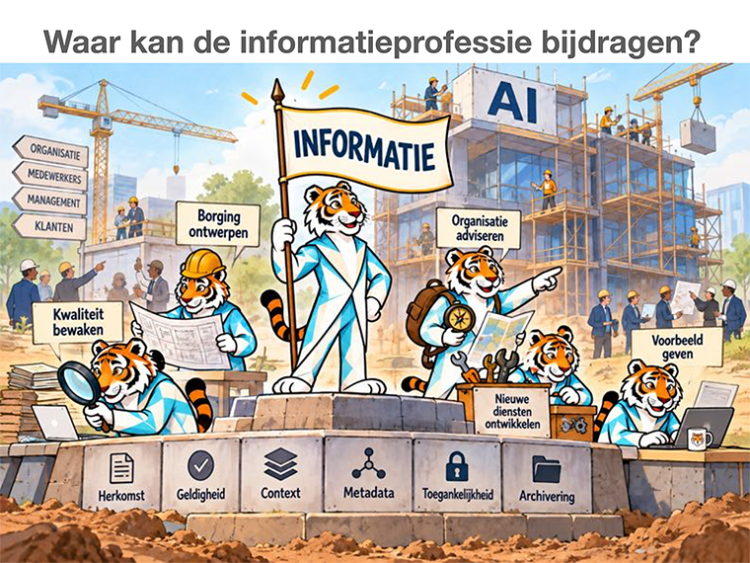
Bijna alle organisaties zijn bezig met AI. ‘Maar wie is eigenlijk de verantwoordelijke voor de informatiekwaliteit waarop die AI-systemen draaien?’, vraagt Been. ‘Wie is verantwoordelijk voor de juiste trainingsinformatie? Wie is houder van welke informatie? Wie bepaalt kwaliteitsnormen en bewaartermijnen? Wie autoriseert het gebruik? Al die vragen betekenen dat er nieuwe spelregels nodig zijn voor informatiekwaliteit, organisatiegeheugen en verantwoording. Daar ligt een nieuwe opgave voor de informatieprofessionals: zichtbaar maken wat er in deze informatieroute gebeurt, bewustzijn creëren, disciplines verbinden en helpen de nieuwe spelregels te ontwerpen en te verankeren. En daar is een duidelijk informatiemandaat voor nodig.’
‘Veel organisaties schaffen eerst de technologie voor AI aan. Pas daarna kijken ze hoe de informatie eruitziet’
SUCCES MET AI BEGINT MET
EEN DUIDELIJK ‘INFORMATIEMANDAAT’
Martijn de Waard
Senior beleidsadviseur informatiehuishouding
Belastingdienst
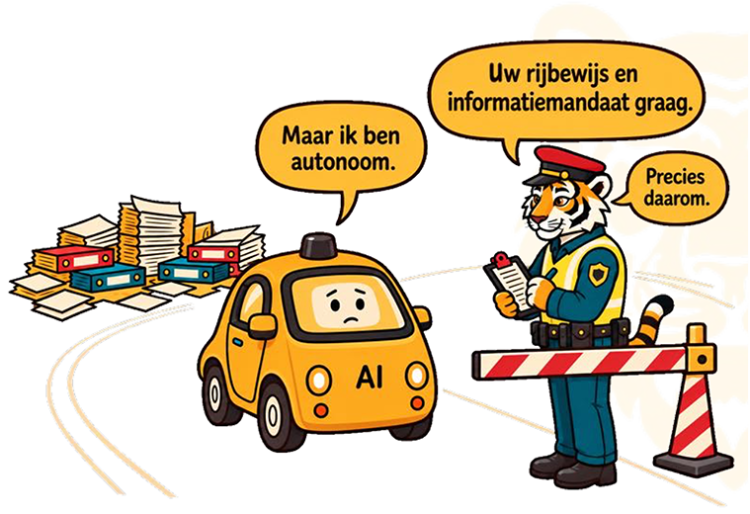
Maar ik ben autonoom.
Uw rijbewijs en ‘informatiemandaat’ graag. Precies daarom.
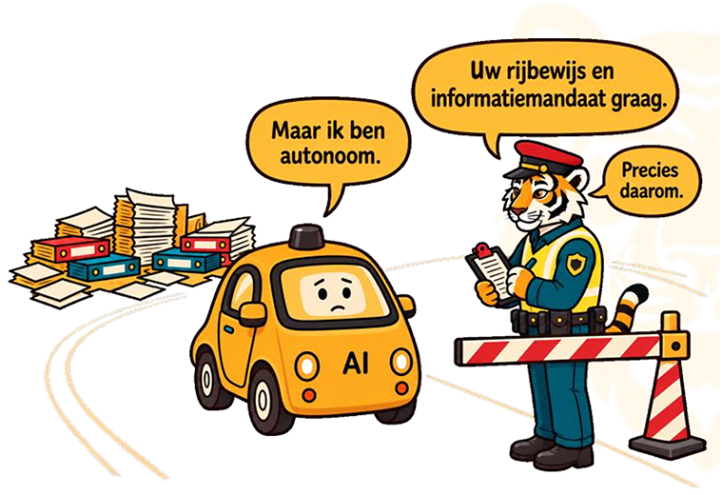
‘AI-geletterdheid zonder – wat ik noem – “informatiemandaat” leidt tot versnelling van bestaande chaos. Dit geeft een groot risico op vertrouwens- en reputatieschade. AI maakt slechte informatie niet beter; AI maakt slechte informatie sneller. Informatie is een bedrijfsmiddel voor het kunnen functioneren van de overheid en krijgt met een informatiemandaat een expliciet houderschap in een bestuursrechtelijke context.’
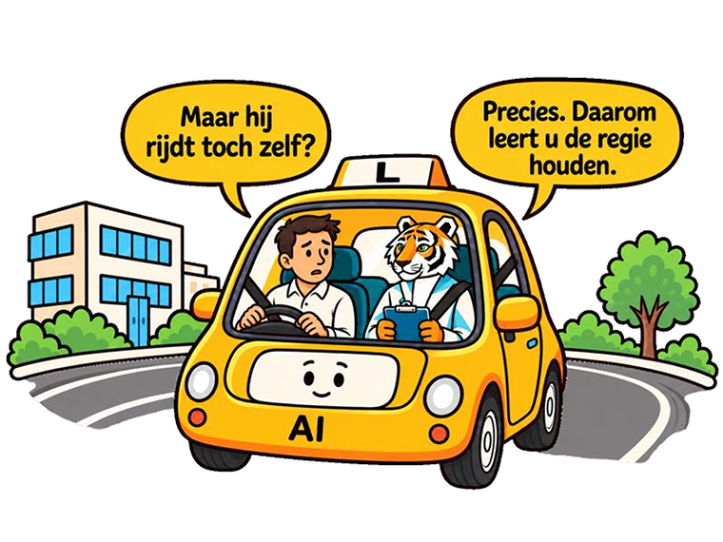
Martijn de Waard heeft een achtergrond in recordmanagement, datamanagement, AI-compliance en procesontwerp en richt zich op het compliant beheren van informatie in techniek én werking. Hij spreekt deze middag als vakgenoot, niet namens zijn werkgever, zegt hij. Rode draad in zijn verhaal is een verkeersmetafoor. Als morgen alle auto’s autonoom rijden, heb je nog steeds wegen, verkeersregels, markeringen en een wegbeheerder nodig. Voor AI geldt hetzelfde. Toch schaffen veel organisaties eerst de technologie voor AI aan. Pas daarna kijken ze hoe de informatie eruitziet.
VIER BOUWSTENEN
Hij werkt deze metafoor uit aan de hand van vier bouwstenen:
1. Informatiebeheerplan (de infrastructuur): legt vast welke informatie er is, wie de houder is, welke kwaliteitseisen er gelden, hoelang en tot welke versie je bewaart en welke openbaarheidsclassificatie geldt.
2. Informatiemandaat (de verkeersregels): één ‘houder’ in het lijnmanagement, aanspreekbaar, bevoegd en verantwoordelijk voor informatie gedurende de hele levenscyclus. Net zoals er mandaten bestaan voor geld en personeel.
3. Information lifecycle agent (schoont de informatiehuishouding continu op): signaleert overbodige, dubbele en verouderde informatie. Doet voorstellen voor metadata, classificatie, archivering en vernietiging.
4. First-time-right-aanpak (nieuwe systemen zijn vanaf dag één AI-ready ingericht): informatie vanaf het begin goed en volgens de wet opslaan.
Deze vier bouwstenen vormen samen een cyclus. Die fasen worden steeds opnieuw doorlopen, omdat AI zelf ook weer informatie oplevert, aldus De Waard.
AI MAAKT SLECHTE INFORMATIE SNELLER
Organisaties die AI betrouwbaar willen inzetten en kunnen uitleggen hoe een uitkomst tot stand kwam, moeten eerst hun informatiebasis op orde hebben, vindt De Waard. ‘AI maakt slechte informatie immers niet beter, maar wel sneller. Informatiekwaliteit, archivering, metadata, houderschap en bewaartermijnen zijn harde voorwaarden voor betrouwbare AI. Richt nieuwe systemen zo in dat informatie vanaf het begin op de juiste manier en volgens de AVG, Archiefwet, Woo en beveiligingseisen wordt opgeslagen.’
METADATA BLIJVEN NODIG, JUIST BIJ AI
Dat betekent dat in een organisatie duidelijk moet zijn wie lijnverantwoordelijk is voor de informatie waarmee een AI-model wordt getraind en voor de output ervan’, vervolgt hij. ‘Daarvoor zijn een informatiemandaat, budget en personeel nodig. Ook is het van belang om te weten welke informatieobjecten er zijn, wie de houder is, welke kwaliteitseisen er gelden, hoelang en tot welke versie je bewaart, welke openbaarheidsclassificatie geldt en welke beheerhandelingen nodig zijn. Wat voor de ene afdeling output is, is voor de andere input. Leg vast welke dossiers waar horen, zodat versnippering, overlap en gaten verdwijnen. Metadata blijven nodig, juist bij AI; context is niet altijd uit het document zelf af te leiden. Eenmalig gevalideerde metadata maken latere zoekvragen bovendien goedkoper.’
‘De eerlijkheid van een AI-toepassing komt pas laat in het ontwerpproces ter sprake, terwijl die erin verweven moet worden’
RESPONSIBLE AI & GOVERNANCE.
LESSEN UIT GPT-NL EN ANDERE PROJECTEN
Eliza Hobo
Digital Ethics, Responsible AI, GPT-NL
TNO
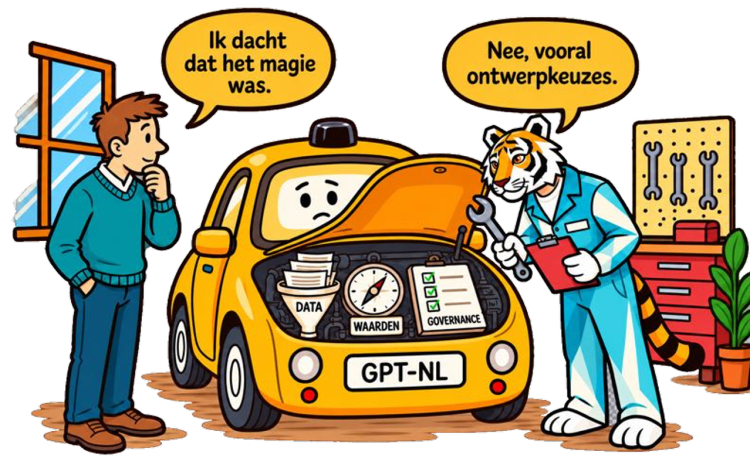
Ik dacht dat AI magie was.
Nee. Het zijn vooral ontwerpkeuzes.
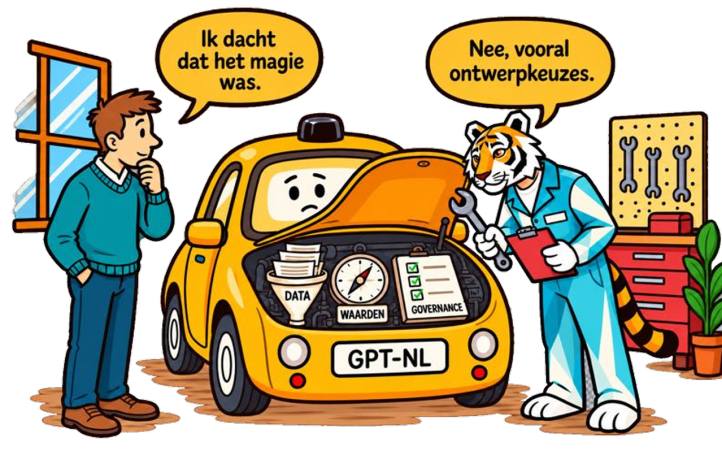
‘AI kan wel magisch lijken, maar in mijn werk bij GPT-NL zie ik juist hoe menselijk het bouwen van AI is. Achter elk AI-model zitten duizenden ontwerpkeuzes: welke data neem je mee, welke filter je eruit, welke aannames en waarden komen in het model terecht?’
De taalmodellen achter de bekende chatbots zijn ontwikkeld door techgiganten zoals Meta, Google en Microsoft. Ze zijn getraind met teksten vol fouten en vooroordelen. Bovendien schenden ze op grote schaal het auteursrecht. Onderzoeksinstituut TNO, ICT-organisatie SURF en het Nederlands Forensisch Instituut (NFI) werken daarom aan een Nederlands alternatief: GPT-NL. Dit taalmodel wordt gevoed met Nederlandstalige bronnen en ontwikkeld volgens Nederlandse en Europese publieke waarden. Maar hoe bouw je een verantwoord AI-systeem? Welke technische, ethische én informatiekundige uitdagingen kom je daarbij tegen?
‘De eerlijkheid van een AI-toepassing komt pas laat in het ontwerpproces ter sprake’, constateert Eliza Hobo. ‘Terwijl dit verweven moet worden in het ontwikkelproces. Dat betekent dat de eindgebruikers erbij betrokken zijn en ook dat de eigen positie van de ontwikkelaars moet worden onderzocht.’ Centrale stelling in het betoog van Hobo is dat AI geen natuurkracht is, maar een product van ontwerpkeuzes.
AUTEURSRECHT EN TAALGEBRUIK
Data zijn het enige echte ingrediënt van een large language model (LLM), een geavanceerd type kunstmatige intelligentie dat is getraind om menselijke taal te begrijpen, te verwerken en te genereren. Het Amerikaanse Anthropic (en inmiddels ook andere AI-bedrijven) heeft miljoenen zeldzame, niet meer verkrijgbare boeken opgekocht om zijn AI-chatbot Claude te trainen. ‘De auteurs ontvangen daar geen vergoeding voor. GPT-NL daarentegen betaalt 50 procent van de opbrengsten van de commerciële licenties aan de eigenaars van de data, zoals auteurs, journalisten en artiesten’, weet Hobo.
De dataset bepaalt wat het model kan, weet en verwacht. Deze data moeten daarom divers zijn, weet ze. ‘Qua schrijfstijl, onderwerp, lengte, leeftijd, dialect en schrijverseigenschappen. Tegelijkertijd mogen de data niet schadelijk zijn; het is bijvoorbeeld niet wenselijk dat het taalmodel scheldt. Echter: wie bepaalt dat? Er bestaat het risico dat het model bepaald taalgebruik, bijvoorbeeld van gemarginaliseerde groepen, niet leert en daardoor voor deze groepen minder goed werkt. Verantwoord gebruik van AI valt, of staat, met verantwoord keuzes maken.’
WAT IS EEN AARDAPPEL?
Een goede training van een dataset is dus cruciaal. Zo ook bij de ontwikkeling van GPT-NL. Hobo geeft als voorbeeld verschillende antwoorden op de prompt: ‘Een aardappel is …’ Na training met circa 3 miljard tokens (een woord, deel van een woord of leesteken) geeft het model het volgende antwoord: ‘… een belangrijk onderdeel van de voedselketen. Het gaat om het behoud van biodiversiteit en het vergroten van de weerbaarheid tegen klimaatverandering. De eiwittransitie moet leiden tot minder gebruik van gewasbeschermingsmiddelen, meer plantaardige alternatieven voor dierlijke mest’.
Na training met ongeveer 350 miljard tokens luidt het antwoord: ‘… een plant, die in de grond wortelt en waarvan het loof dient als voedsel voor dieren. De aardappel is dus een gewas. Het telen van gewassen is een landbouwactiviteit’.
Hoe meer informatie, hoe passender het antwoord. Maar het voorbeeld laat ook zien dat vooruitgang nog niet hetzelfde is als betrouwbaarheid.
BELANG VAN INFORMATIEPROFESSIONALITEIT
BIJ STRATEGISCHE INZET VAN AI
Patrick Loffeld
R&D program manager for digital transformation
AkzoNobel
Maar AI werkt toch vanzelf?
Precies. Daarom
leer je de regie houden.
‘AI is niet meer weg te denken uit de chemische industrie: ‘AI will not replace the chemist, but the chemist that uses AI will replace the chemist that doesn’t.’ Nu de mogelijkheden en kansen om de productiviteit te verhogen exponentieel groeien, neemt ook de behoefte toe om de keerzijde van het gebruik van AI beter te begrijpen. Hallucinaties en onveilig en/of onverantwoord gebruik van tools liggen op de loer, met mogelijk zichtbare en onzichtbare schade aan de business tot gevolg.’
De lezing van Patrick Loffeld gaat over hoe organisaties zich hiertegen kunnen wapenen. De aanpak van AkzoNobel richt zich onder andere op de verandercomponent van AI: hoe nemen we onze werknemers mee richting een toekomst waar AI een geïntegreerd onderdeel is van onze manier van werken? ‘AI verandert onderzoek en ontwikkeling binnen een wereldwijd industrieel bedrijf. Daarbij zijn de kwaliteit en het beheer van informatie minstens zo belangrijk als de AI-technologie zelf.’ Hij gaat in op de verschuiving van het aanvankelijke enthousiasme en de scepsis rond generatieve AI naar een meer gestructureerde aanpak, gericht op veilige toepassingen, training van medewerkers, menselijke verantwoordelijkheid en praktische inzet binnen duidelijke kaders.
STERKE DATAFUNDERING
Een centraal thema in Loffelds verhaal is dat succesvolle AI-adoptie afhankelijk is van een sterke datafundering. Belangrijke uitdagingen daarbij zijn hoe organisaties data vastleggen, analyseren, beveiligen, standaardiseren en toegankelijk maken binnen complexe processen. ‘AI verandert hoe informatie ontstaat en hoe we die gebruiken. Maar de manier waarop informatie is georganiseerd, bepaalt wat AI kan. Wie de informatie inricht, bewaakt daarmee de genen van AI.’
DIGITALE WERKOMGEVING VAN DE TOEKOMST
EN DE PLAATS VAN AI HIERIN
Jeroen Jonkers
Strategisch adviseur
CIO Rijk, ministerie BZK
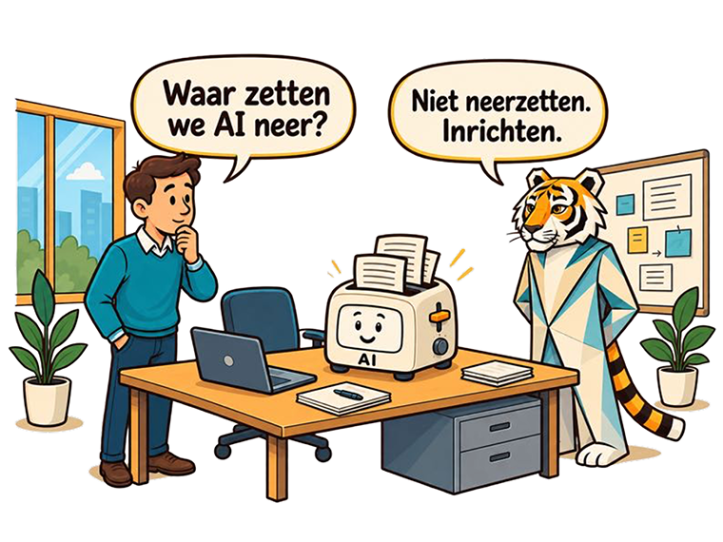
Waar zetten we AI neer?
Niet neerzetten: inrichten!
‘Hoe voorkom je dat systemen frustreren in plaats van faciliteren? Hoe organiseer je informatie zodat die vindbaar, deelbaar en duurzaam toegankelijk blijft? En wat vraagt dit van digitaal vakmanschap? Dit zijn vraagstukken die sowieso al essentieel zijn voor organisaties, en AI voegt daar een extra dimensie aan toe. Per saldo vraagt dit om een wijd perspectief op hoe medewerkers veilig, effectief en verantwoord kunnen werken.’
Welke plaats heeft AI in de digitale werkomgeving van de toekomst? En hoe organiseer je informatie zo dat die vindbaar, deelbaar en duurzaam toegankelijk blijft? Jeroen Jonkers geeft de toehoorders inzicht in hoe binnen de Rijksoverheid naar die digitale werkomgeving van de toekomst wordt gekeken. De Rijksoverheid plaatst die doorgaans binnen de Nederlandse Digitaliseringsstrategie, als onderdeel van een brede beweging rond digitaal vakmanschap, veilig en effectief werken, informatiehuishouding, autonomie en AI.
REGIE OP INFORMATIEKWALITEIT UITBREIDEN
Nu AI de kern van kenniswerk verandert, ontstaat de noodzaak voor nieuwe spelregels voor informatiekwaliteit, organisatiegeheugen en verantwoording. De informatieprofessional is aan zet om de regie op informatiekwaliteit uit te breiden naar AI-processen, stelt hij. ‘En om duidelijk te maken dat kwaliteit, status en herkomst ook bij de bronnen horen die AI gebruikt en de bewerkingen die AI uitvoert. Op deze manier zijn adviezen, besluiten en dossiers later te reconstrueren en te verantwoorden.’
MEER KENNIS EN BUDGET
Na afloop van de presentaties is er ruimte voor discussie. Tijdens de borrel met hapjes en (uiteraard) Tijgernootjes spreken de bezoekers hun waardering uit: de sessie heeft een mooi en breed overzicht gegeven van de mogelijkheden, risico’s en uitdagingen van AI in informatiemanagement. Ze zijn het erover eens dat ‘we met elkaar een enorme digitale afvalhoop hebben gecreëerd waar vooralsnog niemand verantwoordelijkheid voor lijkt te nemen’. De besproken uitdagingen én keuzes die organisaties moeten maken bij het bouwen van een AI-model worden zeer gewaardeerd.
Algehele conclusie is dat informatieprofessionals meer kennis over AI moeten vergaren en dat daar meer budget voor nodig is. Verder moet duidelijk zijn wie de AI-verantwoordelijke in de lijn is. Ook vinden de deelnemers dat we als samenleving meer moeten inzetten op het taalmodel van eigen bodem, speciaal ontwikkeld voor de Nederlandse taal, cultuur en wetgeving: kortom op GPT-NL.
> Je vindt alle 26 afleveringen van de artikelenreeks ‘AI in het informatiedomein’ in het archief op informatieprofessional.nl (trefwoord ‘AI informatiedomein’), in full-text en in opgemaakte vorm. In de volgende IP pakken we de serie weer op met deel #27. <
‘De informatieprofessional is aan zet om de regie op informatiekwaliteit uit te breiden naar AI-processen’

IP | vakblad voor informatieprofessionals | 07 / 2026
Robert Jan
Verstoep
JON HOOFWIJK
AI IN HET INFORMATIEDOMEIN LIVE
AI in het informatiedomein live
In deze oktobereditie van het blad lees je niet deel #27 van de serie AI in het informatiedomein. Ter viering van 30 jaar Informatieprofessional sloegen Simon Been, de auteur van de artikelenreeks, en IP voor deze keer de handen ineen en organiseerden ze samen een inspirerende sessie bij het Stadsarchief Rotterdam. Een verslag van de praktijkervaringen van zes sprekers over – jawel, toch – AI in het informatiedomein.
Martijn
de Waard
Simon
Been
Eliza
Hobo
Patrick
Loffeld
Jon Hoofwijk
Studeerde algemene en vergelijkende literatuurwetenschap aan de Universiteit van Amsterdam en Universität Essen (D) en multimedia bij IBM; sinds 1996 schrijft hij over IT en aanverwante onderwerpen
Dinsdag 29 september, na het middaguur. In het Stadsarchief Rotterdam komen vakgenoten bijeen om te luisteren naar een gevarieerd gezelschap van sprekers van overheden en non-profitorganisaties en uit het bedrijfsleven. En om met elkaar in gesprek te gaan natuurlijk. De middag is georganiseerd als een heterdaadsessie, de term die Simon Been (Papieren Tijger Netwerk) gebruikt voor zijn interactieve bijeenkomsten en kennissessies. Gastheer (en spreker) is Robert Jan Verstoep, teamleider e-depot, databeheer & innovatie bij het Stadsarchief Rotterdam; Eric Daamen, teamleider Bureau Stadsarchivaris, is medeorganisator binnen het stadsarchief.
Been is nu eens niet auteur, maar middagvoorzitter. Het thema van de sessie luidt: ‘AI herschrijft het informatie-DNA: de informatieprofessie aan zet’. Been opent de middag met de stelling: ‘AI is een informatievraagstuk en dat is jouw domein!’ Voor de één is AI een fascinerend onderwerp dat de mensheid naar een nieuw niveau tilt en kansenongelijkheid verkleint. Voor de ander is het een doos van Pandora vol plagen, angst en beven. Hoe je het ook bekijkt, in het informatievakgebied kan en zal de impact groot zijn. ChatGPT en alle zusjes en broertjes daarvan veranderen het werken met, en genereren van, informatie structureel, houdt Been zijn publiek voor. Dat zal ook blijken uit de presentaties van de sprekers.
WELKOM BIJ HET STADSARCHIEF
Robert Jan Verstoep
Teamleider e-depot, databeheer en innovatie
Stadsarchief Rotterdam
Werkt AI gewoon vanzelf?
Nee. Op informatie.
Dus die moet deugen.
Robert Jan Verstoep laat zien hoe veelzijdig en actueel een modern archief kan zijn. Stadsarchief Rotterdam beheert de informatie en verhalen van de stad, houdt toezicht op het gemeentelijke informatiebeheer en werkt aan duurzame digitale toegankelijkheid. Met onderzoek, educatie en projecten rond actuele stedelijke vraagstukken verbindt het archief historische bronnen met het Rotterdam van vandaag. Ook werkt het samen met bewoners en maatschappelijke partners aan een collectie waarin uiteenlopende gemeenschappen en perspectieven zichtbaar worden.
VAN GARAGE TOT GEHEUGEN VAN DE STAD
Stadsarchief Rotterdam is gevestigd in de voormalige Rijks Automobiel Centrale van architect H.A. Maaskant. Het gebouw uit 1960 diende tot 1991 als garage voor ruim vierhonderd rijksvoertuigen waaronder die van de PTT. In 1995 besloot de gemeente om het leegstaande pand te verbouwen tot stadsarchief. Prins Claus opende het in 1999. Er is 6.000 vierkante meter depotruimte (ter vergelijking: De Kuip heeft een voetbalveld van 7.140 vierkante meter). Verder heeft het stadsarchief een koeldepot voor films. Bij de verbouwing werden milieuvriendelijke, duurzame materialen gebruikt, verhaalt Verstoep. Er is gelet op energiewinning en energiebesparing, zoals zonnepanelen op het dak, regenwater verzameld voor het doorspoelen van de toiletten, koude- en warmteopslag in de bodem voor de klimaatbeheersing in het gebouw en zoveel mogelijk daglicht en energiezuinige verlichting en apparatuur.
GEEN IT-, MAAR INFORMATIEVRAGEN
In het gebouw liggen eeuwen aan besluiten, akten, registers, kaarten en foto’s. ‘Al deze papieren documenten zijn in de loop van de tijd gedigitaliseerd’, vertelt Verstoep. ‘Verder is het archief uitgebreid met een e-depot: e-mails, databases, websites en documenten die nooit op papier hebben bestaan. Het stadsarchief zorgt ervoor dat deze digitale informatie tientallen jaren leesbaar en betrouwbaar blijft, volgens internationale standaarden.’
Het stadsarchief doet echter meer dan alleen bewaren. Beheerders kijken ook naar de herkomst van de informatie en naar de context waarin deze is ontstaan. En of het materiaal authentiek is – is het wat het zegt te zijn? Kortom, precies de vragen die nu op tafel liggen bij AI. ‘Het Stadsarchief maakt gebruik van AI om historische bronnen te doorzoeken’, zegt Verstoep. ‘En om handschrift om te zetten, en namen en entiteiten automatisch te herkennen zodat collecties beter vindbaar en verbonden zijn. Handmatig zou dit zeer bewerkelijk zijn. In akten en in de burgerlijke stand zitten immers miljoenen namen verborgen. Dit zijn geen IT-vragen, maar informatievragen waarbij alles draait om kwaliteit, metadata en verantwoordelijkheid.’
AI IS EEN INFORMATIEVRAAGSTUK
EN DAT IS JOUW DOMEIN
Simon Been
Auteur, spreker en trainer rond AI in het informatiedomein
TijgerBrains
AI verandert de kern van kenniswerk. Midden in dit geheel staat de kenniswerker. Die geeft opdrachten, beoordeelt antwoorden en stuurt bij.
VIER MISVATTINGEN OVER AI
Simon Been begint zijn presentatie met de fundamentele vraag: wat is AI echt? Het antwoord geeft hij aan de hand van vier misvattingen over AI. De eerste misvatting is dat het gewoon een computer is waarbij alles om data draait. ‘Dat is niet juist. AI loopt op informatie. Alles draait om context en samenhang. AI is, kortom, een contextmachine. De tweede misvatting is dat veel mensen denken dat ze AI kennen als ze er een keer mee hebben geëxperimenteerd. Ook dat is niet zo. AI is zoveel meer dan een “brein”. Sinds de introductie van ChatGPT voor een breed publiek eind 2022 is er heel veel bijgekomen. De ontwikkelingen gaan razendsnel.’
De derde misvatting die Been noemt: als je een aantal keren prompts aan je computer hebt gegeven, weet je wat AI is. Nee dus. ‘Zo’n instructie, vraag of commando is slechts één ervaring. AI voor kenniswerk is óók doorvragen, sparren, onderzoeken en herschrijven. De laatste misvatting is dat de tekst of het antwoord van AI correct is als je dit maar nakijkt. Controle door de human in the loop is echter bij lange na niet genoeg. Je controleer alleen wat je kunt zien. Je weet niet hoe AI tot het antwoord is gekomen, welke bronnen er zijn gebruikt en welke niet.’
RELEVANTE INFORMATIE BUITEN BEELD
AI nestelt zich in de route van broninformatie naar adviezen, besluiten en dossiers, vertelt Been. ‘AI zoekt, selecteert, rangschikt, combineert, interpreteert en genereert. Relevante informatie kan buiten beeld blijven, terwijl concepten, oude versies of vaak herhaalde aannames juist gewicht krijgen. Voor de gebruiker blijft die selectie meestal grotendeels onzichtbaar. Uitkomsten van AI gebruikt AI later óók weer als bron. Een onduidelijke status, gemiste nuance of onjuiste aanname kan zo verder door de organisatie reizen en deel gaan uitmaken van het organisatiegeheugen.’
BEHOEFTE AAN INFORMATIE-INTELLIGENTIE
Elders in de organisatie verandert AI de kern van kenniswerk: van research tot analyse en van brainstormen tot sparren en formuleren. ‘Vertrouwde stappen worden overgeslagen. Status en herkomst van informatie worden diffuus, dossiers krijgen blinde vlekken. Gebrekkige AI-inzet opent daarmee diverse valkuilen, van ontoereikende informatiekwaliteit tot problematische verantwoording en een (nog meer) vervuild organisatiegeheugen’, aldus Been.
Zo herschrijft AI het informatie-DNA: de basisregels waarmee een organisatie bepaalt welke informatie zij vertrouwt, hoe zij die gebruikt, wat zij bewaart en hoe zij zich daarover verantwoord. ‘De human in the loop biedt geen soelaas wanneer zaken zoals bronkeuze, status, tussenstappen en doorwerking niet zichtbaar en toetsbaar zijn. Er is, kortom, een grote behoefte aan informatie-intelligentie voor betrouwbare inzet van AI.’
DUIDELIJK INFORMATIEMANDAAT NODIG
Bijna alle organisaties zijn bezig met AI. ‘Maar wie is eigenlijk de verantwoordelijke voor de informatiekwaliteit waarop die AI-systemen draaien?’, vraagt Been. ‘Wie is verantwoordelijk voor de juiste trainingsinformatie? Wie is houder van welke informatie? Wie bepaalt kwaliteitsnormen en bewaartermijnen? Wie autoriseert het gebruik? Al die vragen betekenen dat er nieuwe spelregels nodig zijn voor informatiekwaliteit, organisatiegeheugen en verantwoording. Daar ligt een nieuwe opgave voor de informatieprofessionals: zichtbaar maken wat er in deze informatieroute gebeurt, bewustzijn creëren, disciplines verbinden en helpen de nieuwe spelregels te ontwerpen en te verankeren. En daar is een duidelijk informatiemandaat voor nodig.’
SUCCES MET AI BEGINT MET
EEN DUIDELIJK ‘INFORMATIEMANDAAT’
Martijn de Waard
Senior beleidsadviseur informatiehuishouding
Belastingdienst
Maar ik ben autonoom.
Uw rijbewijs en ‘informatiemandaat’ graag. Precies daarom.
‘AI-geletterdheid zonder – wat ik noem – “informatiemandaat” leidt tot versnelling van bestaande chaos. Dit geeft een groot risico op vertrouwens- en reputatieschade. AI maakt slechte informatie niet beter; AI maakt slechte informatie sneller. Informatie is een bedrijfsmiddel voor het kunnen functioneren van de overheid en krijgt met een informatiemandaat een expliciet houderschap in een bestuursrechtelijke context.’
Martijn de Waard heeft een achtergrond in recordmanagement, datamanagement, AI-compliance en procesontwerp en richt zich op het compliant beheren van informatie in techniek én werking. Hij spreekt deze middag als vakgenoot, niet namens zijn werkgever, zegt hij. Rode draad in zijn verhaal is een verkeersmetafoor. Als morgen alle auto’s autonoom rijden, heb je nog steeds wegen, verkeersregels, markeringen en een wegbeheerder nodig. Voor AI geldt hetzelfde. Toch schaffen veel organisaties eerst de technologie voor AI aan. Pas daarna kijken ze hoe de informatie eruitziet.
VIER BOUWSTENEN
Hij werkt deze metafoor uit aan de hand van vier bouwstenen:
1. Informatiebeheerplan (de infrastructuur): legt vast welke informatie er is, wie de houder is, welke kwaliteitseisen er gelden, hoelang en tot welke versie je bewaart en welke openbaarheidsclassificatie geldt.
2. Informatiemandaat (de verkeersregels): één ‘houder’ in het lijnmanagement, aanspreekbaar, bevoegd en verantwoordelijk voor informatie gedurende de hele levenscyclus. Net zoals er mandaten bestaan voor geld en personeel.
3. Information lifecycle agent (schoont de informatiehuishouding continu op): signaleert overbodige, dubbele en verouderde informatie. Doet voorstellen voor metadata, classificatie, archivering en vernietiging.
4. First-time-right-aanpak (nieuwe systemen zijn vanaf dag één AI-ready ingericht): informatie vanaf het begin goed en volgens de wet opslaan.
Deze vier bouwstenen vormen samen een cyclus. Die fasen worden steeds opnieuw doorlopen, omdat AI zelf ook weer informatie oplevert, aldus De Waard.
AI MAAKT SLECHTE INFORMATIE SNELLER
Organisaties die AI betrouwbaar willen inzetten en kunnen uitleggen hoe een uitkomst tot stand kwam, moeten eerst hun informatiebasis op orde hebben, vindt De Waard. ‘AI maakt slechte informatie immers niet beter, maar wel sneller. Informatiekwaliteit, archivering, metadata, houderschap en bewaartermijnen zijn harde voorwaarden voor betrouwbare AI. Richt nieuwe systemen zo in dat informatie vanaf het begin op de juiste manier en volgens de AVG, Archiefwet, Woo en beveiligingseisen wordt opgeslagen.’
METADATA BLIJVEN NODIG, JUIST BIJ AI
Dat betekent dat in een organisatie duidelijk moet zijn wie lijnverantwoordelijk is voor de informatie waarmee een AI-model wordt getraind en voor de output ervan’, vervolgt hij. ‘Daarvoor zijn een informatiemandaat, budget en personeel nodig. Ook is het van belang om te weten welke informatieobjecten er zijn, wie de houder is, welke kwaliteitseisen er gelden, hoelang en tot welke versie je bewaart, welke openbaarheidsclassificatie geldt en welke beheerhandelingen nodig zijn. Wat voor de ene afdeling output is, is voor de andere input. Leg vast welke dossiers waar horen, zodat versnippering, overlap en gaten verdwijnen. Metadata blijven nodig, juist bij AI; context is niet altijd uit het document zelf af te leiden. Eenmalig gevalideerde metadata maken latere zoekvragen bovendien goedkoper.’
RESPONSIBLE AI & GOVERNANCE.
LESSEN UIT GPT-NL EN ANDERE PROJECTEN
Eliza Hobo
Digital Ethics, Responsible AI, GPT-NL
TNO
Ik dacht dat AI magie was.
Nee. Het zijn vooral ontwerpkeuzes.
‘AI kan wel magisch lijken, maar in mijn werk bij GPT-NL zie ik juist hoe menselijk het bouwen van AI is. Achter elk AI-model zitten duizenden ontwerpkeuzes: welke data neem je mee, welke filter je eruit, welke aannames en waarden komen in het model terecht?’
De taalmodellen achter de bekende chatbots zijn ontwikkeld door techgiganten zoals Meta, Google en Microsoft. Ze zijn getraind met teksten vol fouten en vooroordelen. Bovendien schenden ze op grote schaal het auteursrecht. Onderzoeksinstituut TNO, ICT-organisatie SURF en het Nederlands Forensisch Instituut (NFI) werken daarom aan een Nederlands alternatief: GPT-NL. Dit taalmodel wordt gevoed met Nederlandstalige bronnen en ontwikkeld volgens Nederlandse en Europese publieke waarden. Maar hoe bouw je een verantwoord AI-systeem? Welke technische, ethische én informatiekundige uitdagingen kom je daarbij tegen?
‘De eerlijkheid van een AI-toepassing komt pas laat in het ontwerpproces ter sprake’, constateert Eliza Hobo. ‘Terwijl dit verweven moet worden in het ontwikkelproces. Dat betekent dat de eindgebruikers erbij betrokken zijn en ook dat de eigen positie van de ontwikkelaars moet worden onderzocht.’ Centrale stelling in het betoog van Hobo is dat AI geen natuurkracht is, maar een product van ontwerpkeuzes.
AUTEURSRECHT EN TAALGEBRUIK
Data zijn het enige echte ingrediënt van een large language model (LLM), een geavanceerd type kunstmatige intelligentie dat is getraind om menselijke taal te begrijpen, te verwerken en te genereren. Het Amerikaanse Anthropic (en inmiddels ook andere AI-bedrijven) heeft miljoenen zeldzame, niet meer verkrijgbare boeken opgekocht om zijn AI-chatbot Claude te trainen. ‘De auteurs ontvangen daar geen vergoeding voor. GPT-NL daarentegen betaalt 50 procent van de opbrengsten van de commerciële licenties aan de eigenaars van de data, zoals auteurs, journalisten en artiesten’, weet Hobo.
De dataset bepaalt wat het model kan, weet en verwacht. Deze data moeten daarom divers zijn, weet ze. ‘Qua schrijfstijl, onderwerp, lengte, leeftijd, dialect en schrijverseigenschappen. Tegelijkertijd mogen de data niet schadelijk zijn; het is bijvoorbeeld niet wenselijk dat het taalmodel scheldt. Echter: wie bepaalt dat? Er bestaat het risico dat het model bepaald taalgebruik, bijvoorbeeld van gemarginaliseerde groepen, niet leert en daardoor voor deze groepen minder goed werkt. Verantwoord gebruik van AI valt, of staat, met verantwoord keuzes maken.’
WAT IS EEN AARDAPPEL?
Een goede training van een dataset is dus cruciaal. Zo ook bij de ontwikkeling van GPT-NL. Hobo geeft als voorbeeld verschillende antwoorden op de prompt: ‘Een aardappel is …’ Na training met circa 3 miljard tokens (een woord, deel van een woord of leesteken) geeft het model het volgende antwoord: ‘… een belangrijk onderdeel van de voedselketen. Het gaat om het behoud van biodiversiteit en het vergroten van de weerbaarheid tegen klimaatverandering. De eiwittransitie moet leiden tot minder gebruik van gewasbeschermingsmiddelen, meer plantaardige alternatieven voor dierlijke mest’.
Na training met ongeveer 350 miljard tokens luidt het antwoord: ‘… een plant, die in de grond wortelt en waarvan het loof dient als voedsel voor dieren. De aardappel is dus een gewas. Het telen van gewassen is een landbouwactiviteit’.
Hoe meer informatie, hoe passender het antwoord. Maar het voorbeeld laat ook zien dat vooruitgang nog niet hetzelfde is als betrouwbaarheid.
BELANG VAN INFORMATIEPROFESSIONALITEIT
BIJ STRATEGISCHE INZET VAN AI
Patrick Loffeld
R&D program manager for digital transformation
AkzoNobel
Maar AI werkt toch vanzelf?
Precies. Daarom
leer je de regie houden.
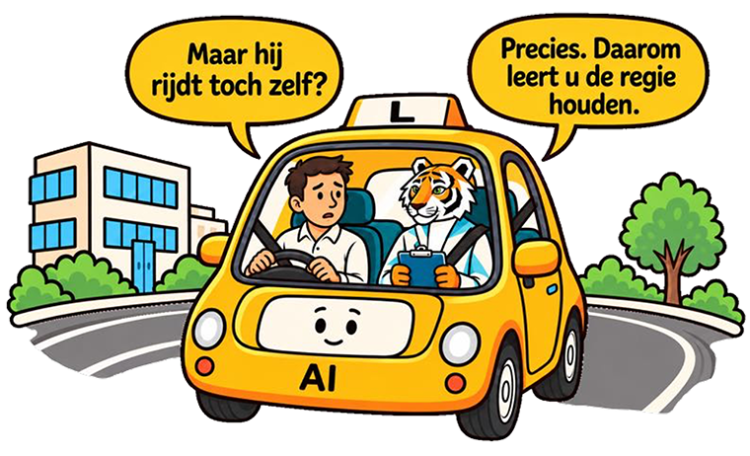
‘AI is niet meer weg te denken uit de chemische industrie: ‘AI will not replace the chemist, but the chemist that uses AI will replace the chemist that doesn’t.’ Nu de mogelijkheden en kansen om de productiviteit te verhogen exponentieel groeien, neemt ook de behoefte toe om de keerzijde van het gebruik van AI beter te begrijpen. Hallucinaties en onveilig en/of onverantwoord gebruik van tools liggen op de loer, met mogelijk zichtbare en onzichtbare schade aan de business tot gevolg.’
De lezing van Patrick Loffeld gaat over hoe organisaties zich hiertegen kunnen wapenen. De aanpak van AkzoNobel richt zich onder andere op de verandercomponent van AI: hoe nemen we onze werknemers mee richting een toekomst waar AI een geïntegreerd onderdeel is van onze manier van werken? ‘AI verandert onderzoek en ontwikkeling binnen een wereldwijd industrieel bedrijf. Daarbij zijn de kwaliteit en het beheer van informatie minstens zo belangrijk als de AI-technologie zelf.’ Hij gaat in op de verschuiving van het aanvankelijke enthousiasme en de scepsis rond generatieve AI naar een meer gestructureerde aanpak, gericht op veilige toepassingen, training van medewerkers, menselijke verantwoordelijkheid en praktische inzet binnen duidelijke kaders.
STERKE DATAFUNDERING
Een centraal thema in Loffelds verhaal is dat succesvolle AI-adoptie afhankelijk is van een sterke datafundering. Belangrijke uitdagingen daarbij zijn hoe organisaties data vastleggen, analyseren, beveiligen, standaardiseren en toegankelijk maken binnen complexe processen. ‘AI verandert hoe informatie ontstaat en hoe we die gebruiken. Maar de manier waarop informatie is georganiseerd, bepaalt wat AI kan. Wie de informatie inricht, bewaakt daarmee de genen van AI.’
DIGITALE WERKOMGEVING
VAN DE TOEKOMST
EN DE PLAATS VAN AI HIERIN
Jeroen Jonkers
Strategisch adviseur
CIO Rijk, ministerie BZK
Waar zetten we AI neer?
Niet neerzetten: inrichten!
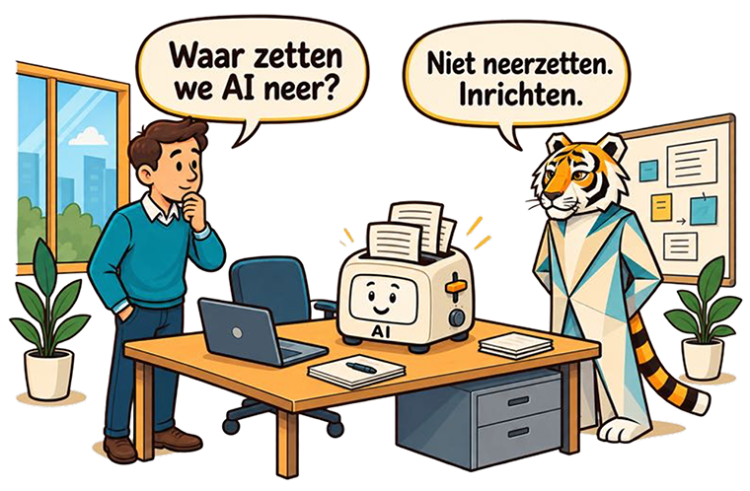
‘Hoe voorkom je dat systemen frustreren in plaats van faciliteren? Hoe organiseer je informatie zodat die vindbaar, deelbaar en duurzaam toegankelijk blijft? En wat vraagt dit van digitaal vakmanschap? Dit zijn vraagstukken die sowieso al essentieel zijn voor organisaties, en AI voegt daar een extra dimensie aan toe. Per saldo vraagt dit om een wijd perspectief op hoe medewerkers veilig, effectief en verantwoord kunnen werken.’
Welke plaats heeft AI in de digitale werkomgeving van de toekomst? En hoe organiseer je informatie zo dat die vindbaar, deelbaar en duurzaam toegankelijk blijft? Jeroen Jonkers geeft de toehoorders inzicht in hoe binnen de Rijksoverheid naar die digitale werkomgeving van de toekomst wordt gekeken. De Rijksoverheid plaatst die doorgaans binnen de Nederlandse Digitaliseringsstrategie, als onderdeel van een brede beweging rond digitaal vakmanschap, veilig en effectief werken, informatiehuishouding, autonomie en AI.
REGIE OP INFORMATIEKWALITEIT UITBREIDEN
Nu AI de kern van kenniswerk verandert, ontstaat de noodzaak voor nieuwe spelregels voor informatiekwaliteit, organisatiegeheugen en verantwoording. De informatieprofessional is aan zet om de regie op informatiekwaliteit uit te breiden naar AI-processen, stelt hij. ‘En om duidelijk te maken dat kwaliteit, status en herkomst ook bij de bronnen horen die AI gebruikt en de bewerkingen die AI uitvoert. Op deze manier zijn adviezen, besluiten en dossiers later te reconstrueren en te verantwoorden.’
MEER KENNIS EN BUDGET
Na afloop van de presentaties is er ruimte voor discussie. Tijdens de borrel met hapjes en (uiteraard) Tijgernootjes spreken de bezoekers hun waardering uit: de sessie heeft een mooi en breed overzicht gegeven van de mogelijkheden, risico’s en uitdagingen van AI in informatiemanagement. Ze zijn het erover eens dat ‘we met elkaar een enorme digitale afvalhoop hebben gecreëerd waar vooralsnog niemand verantwoordelijkheid voor lijkt te nemen’. De besproken uitdagingen én keuzes die organisaties moeten maken bij het bouwen van een AI-model worden zeer gewaardeerd.
Algehele conclusie is dat informatieprofessionals meer kennis over AI moeten vergaren en dat daar meer budget voor nodig is. Verder moet duidelijk zijn wie de AI-verantwoordelijke in de lijn is. Ook vinden de deelnemers dat we als samenleving meer moeten inzetten op het taalmodel van eigen bodem, speciaal ontwikkeld voor de Nederlandse taal, cultuur en wetgeving: kortom op GPT-NL.
> Je vindt alle 26 afleveringen van de artikelenreeks ‘AI in het informatiedomein’ in het archief op informatieprofessional.nl (trefwoord ‘AI informatiedomein’), in full-text en in opgemaakte vorm. In de volgende IP pakken we de serie weer op met deel #27. <
IP | vakblad voor informatieprofessionals | 07 / 2026